
PostgreSQL 복제 버그: CloudNativePG에서 발견한 13년 된 오류
때로는 Postgres를 다른 방식으로 운영하면서, 그 방식이 아니었다면 프로젝트가 배울 수 없었을 사실을 발견하게 됩니다. 이번 사례가 바로 그렇습니다.
PostgreSQL의 스트리밍 복제 코드에 버전 9.3(2013년 출시)부터 남아 있던 캐스케이딩 스탠바이의 재연결 버그가 지난주 업스트림에서 수정됐습니다. 수정 사항은 지원 중인 모든 브랜치의 다음 마이너 릴리스인 PostgreSQL 18.5, 17.11, 16.15, 15.19, 14.24에 포함될 예정입니다. 이후 EDB Postgres Extended와 EDB Postgres Advanced Server의 해당 릴리스에도 반영될 예정입니다.
이 버그를 발견하고 보고하고 수정한 사람은 EDB의 Esteemed Senior Principal Engineer이자 PostgreSQL의 Significant Contributor이며 CloudNativePG 유지관리자 중 한 명인 Marco Nenciarini입니다. 버그가 드러난 것은 CloudNativePG에서 손쉽게 구축할 수 있는 아키텍처 덕분이었습니다. 여러 리전에 걸쳐 분산된 캐스케이딩 PostgreSQL 토폴로지에서 스트리밍과 아카이브를 함께 사용하는 구성이었습니다.
PostgreSQL 캐스케이딩 복제 버그의 원인과 수정
문제는 StartReplication()에 있습니다. 2013년의 한 커밋은 스트리밍 스탠바이가 타임라인 전환을 따라갈 수 있도록 하면서, 합리적으로 보이는 방어 로직도 추가했습니다. 요청한 로그 시퀀스 번호(LSN)가 업스트림 서버 자체의 WAL 플러시 위치보다 앞선 START_REPLICATION 요청을 거부하는 로직입니다. 일반적인 스트리밍에서는 문제가 없습니다.
하지만 캐스케이딩 스탠바이가 아카이브 복구로 전환한 직후에는 문제가 생깁니다. 아카이브 복구는 개별 레코드가 아니라 WAL 세그먼트 전체를 읽습니다. 따라서 스탠바이가 아카이브의 한 세그먼트 재생을 마치는 순간, 다음 읽기 위치는 정확히 그다음 세그먼트의 경계에 놓입니다. 실제로는 아무 문제가 없어도, 동작 방식상 아직 진행 중인 업스트림의 플러시 포인터보다 앞서게 됩니다. 재연결 시도는 다음과 유사한 오류와 함께 즉시 실패합니다.ERROR: requested starting point 0/A000000 is ahead of the WAL flush position of this server 0/9000000
이후 재시도도 일어나지 않습니다. 캐스케이딩 스탠바이가 잠깐이라도 아카이브로 전환해야 했다면, 업스트림의 스트리밍에 무기한 다시 연결하지 못할 수 있습니다.
수정된 코드에서는 walreceiver가 업스트림의 IDENTIFY_SYSTEM 응답에 보고된 플러시 위치를 확인한 후 START_REPLICATION을 보냅니다. 차이가 최대 한 개의 WAL 세그먼트 이내라면, 즉 아카이브 복구의 세그먼트 단위 처리로 생기는 바로 그 형태의 차이라면, 포기하는 대신 wal_receiver_timeout이 정한 범위 안에서 기다렸다가 재시도합니다.
CloudNativePG에서 버그가 발견된 이유
이 버그가 발생하려면 특정 토폴로지가 필요합니다. 업스트림에서 스트리밍을 받는 스탠바이가 WAL 전송 방식으로도 전환할 수 있고, 여기에 또 다른 노드로 이어지는 캐스케이딩 복제가 구성되어 있어야 합니다. 개념적으로는 특별히 드문 구성이 아닙니다. 하지만 이를 구축하고 운영하면서 일시적인 네트워크 장애를 안정적으로 재현하는 것은 전혀 다른 문제입니다. 운영 환경의 PostgreSQL에서 이 버그가 13년간 남아 있었던 이유도 아마 여기에 있을 것입니다.
CloudNativePG의 분산 토폴로지는 바로 이 아키텍처를 몇 줄의 YAML로 구성하게 해 줍니다. 복제 클러스터는 지정된 프라이머리를 스트리밍, WAL 아카이브 또는 두 방식을 함께 사용하는 지속적 복구 모드로 실행합니다. 그리고 그 아래에는 프라이머리 클러스터와 대칭인 아키텍처를 구성합니다. 자체 로컬 지속적 백업 대상과, 스트리밍을 사용하다가 필요하면 아카이브로 전환해 최신 상태를 유지하는 자체 복제본 집합을 갖춥니다. 이를 의도적으로 대칭적이라고 부릅니다. 복제 클러스터는 부가적으로 붙인 읽기 복제본이 아니라, 동등한 지위를 갖고 승격할 수 있는 클러스터이기 때문입니다.
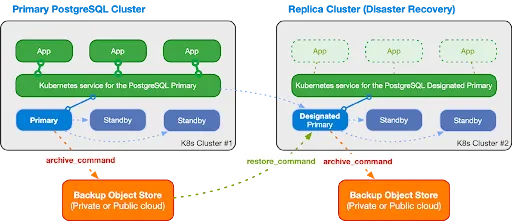
출처: CloudNativePG 문서
여기에 캐스케이딩 복제와 스트리밍·아카이브를 결합한 지속적 복구 전략을 더하면, 앞서 설명한 장애 조건을 필요할 때 재현할 수 있습니다. 이 문제를 겪는 데 여러 리전의 운영 환경이 꼭 필요한 것도 아닙니다. CloudNativePG의 공식 학습 환경인 cnpg-playground는 노트북의 Docker와 Kind에서 Barman Cloud Plugin을 통한 지속적 백업을 포함해 이와 동일한 분산 토폴로지를 재현합니다.
13년간 발견되지 않은 이유: 고가용성과 백업 운영의 분리
왜 이렇게 오랫동안 발견되지 않았는지 살펴볼 필요가 있습니다. 그 답은 업계가 실제로 Postgres를 일상적으로 운영하는 방식에 대해 말해 주기 때문입니다.
두세 개 리전에 걸친 분산 토폴로지를 구축하고, 지속적 백업과 복구를 복제 체계에 제대로 통합하는 작업은 Kubernetes 밖에서 결코 간단하지 않았습니다. 구축 이후의 운영(Day-2 operations)은 다른 환경에서도 자동화되지만, 도구마다 각자의 영역에서 이루어집니다. 고가용성(HA) 도구는 장애 조치와 스위치오버를 처리하고, 백업 도구는 백업과 복구를 처리하며, 서로의 상태는 거의 알지 못합니다. 흔히 HA 도구가 백업 도구를 호출해 새 복제본을 초기 구성할 수 있도록 두 도구를 연결합니다. 그래도 두 시스템은 독립적으로 운영되며, HA 상태와 백업 상태를 함께 조정하는 단일 제어 루프는 없습니다.
이렇게 분리되어 있으면 명령형 방식으로 상황을 수습할 여지가 남습니다. 어느 도구도 자체적으로 해결하도록 설계되지 않은 상황에서 사람이 셸에 접속해 문제를 풀어내는 것입니다.
CloudNativePG는 그런 방식에 기대지 않으며, 그만큼 더 어려운 목표를 세웁니다. 단일 구성 요소가 HA와 백업·복구의 조정을 모두 책임지고, 구축 이후 운영을 개별 명령으로 연결하는 대신 선언형으로 다룹니다. HA는 Kubernetes의 기본 기능에 의존하는 오퍼레이터가 처리합니다. 백업과 복구는 CNPG-I를 통해 확장할 수 있지만, 오퍼레이터 밖에 위임하지 않고 같은 오퍼레이터가 조정합니다. 이러한 접근 덕분에 분산·캐스케이딩·하이브리드 복제 토폴로지를 처음부터 설계하는 대신 선언하고 몇 분 안에 재현할 수 있습니다. 그리고 실제로 이런 구성을 실행하기 때문에, 바로 이러한 워크로드에서 이번과 같은 버그가 드러납니다.
예상을 넘어 성장한 CloudNativePG
CloudNativePG는 개발에 참여한 누구의 예상보다도 빠르게 성장했습니다. 이는 프로젝트에 참여한 모든 이에게 큰 보람과 기쁨을 안겨 주었습니다. 유료 홍보 없이 자연스럽게 이룬 성장입니다. 프로젝트가 오픈소스로 공개된 후 4년 동안 GitHub 스타는 약 9,100개에 이르렀고, 다운로드 수는 2억 1,500만 회를 기록했습니다.
이렇게 빠른 성장에는 불가피한 마찰이라는 대가도 따릅니다. 하지만 우리는 이를 성장 속도를 늦출 이유로 삼기보다, 나아가면서 해결해야 할 과제로 받아들이고 있습니다. 이러한 노력은 Linux Foundation의 Insights 대시보드에 있는 프로젝트 자체의 건전성 지표에서도 확인할 수 있습니다. 중요한 것은 전체적인 발전 방향입니다. CloudNativePG는 2025년 1월 CNCF Sandbox에 합류했으며, 현재 CNCF Technical Oversight Committee에서 Incubation 단계로의 승격을 평가받고 있습니다.
늘 말하듯, CloudNativePG는 Postgres가 이전에 감당할 필요가 없었던 경계까지 나아가게 합니다. 나머지 생태계가 아직 도달하지 못했던 영역을 탐색하면서 끊임없이 관찰하고 배우고 적응하며 개선합니다. 이렇게 보면 13년 동안 남아 있던 버그를 발견한 일이 그리 놀랍지만은 않습니다.
버그 수정에 기여한 사람들
이런 버그는 한 사람의 힘만으로 고쳐지지 않습니다. 간헐적으로 발생해 원인을 잡기 어려웠던 장애를 신뢰할 수 있고 재현 가능한 테스트 사례로 만들 때까지 끈기 있게 추적한 CloudNativePG 팀과 커뮤니티에 감사드립니다. 그 사례를 업스트림에 전달하고 정식 PostgreSQL 수정으로 완성한 Marco Nenciarini에게도 감사드립니다. 검토를 맡은 Xuneng Zhou, 커뮤니티 절차 전반에서 수정을 이끌고 지원 중인 모든 브랜치에 커밋한 Álvaro Herrera에게도 감사를 전합니다.
수정 사항은 업스트림에 커밋됐으며, 다음 마이너 릴리스인 PostgreSQL 18.5, 17.11, 16.15, 15.19, 14.24에 반영될 예정입니다. 자세한 기술 내용은 최초 보고와 커밋을 참고하세요.
자주 묻는 질문
어떤 PostgreSQL 복제 구성에서 이 버그가 발생하나요?
업스트림에서 스트리밍을 받다가 WAL 아카이브 복구로 전환할 수 있는 스탠바이와, 그 아래로 이어지는 캐스케이딩 복제 구성이 필요합니다. 아카이브 재생 후 다음 읽기 위치가 업스트림의 WAL 플러시 위치보다 앞서면 재연결이 실패할 수 있습니다.
수정된 walreceiver는 재연결 오류를 어떻게 처리하나요?
START_REPLICATION 요청 전에 IDENTIFY_SYSTEM 응답의 플러시 위치를 확인합니다. 차이가 최대 한 개의 WAL 세그먼트 이내라면 wal_receiver_timeout이 정한 범위 안에서 기다렸다가 재시도합니다.
CloudNativePG는 이 복제 버그를 찾는 데 어떤 역할을 했나요?
분산·캐스케이딩 토폴로지와 스트리밍·아카이브를 결합한 복구 구성을 선언하고 재현하기 쉽게 만들었습니다. cnpg-playground에서는 노트북의 Docker와 Kind에서도 Barman Cloud Plugin의 지속적 백업을 포함한 분산 토폴로지를 재현할 수 있습니다.
원문이 수정 반영 예정으로 안내한 PostgreSQL 버전은 무엇인가요?
원문은 PostgreSQL 18.5, 17.11, 16.15, 15.19, 14.24의 다음 마이너 릴리스에 수정이 포함될 예정이라고 안내합니다. 이후 EDB Postgres Extended와 EDB Postgres Advanced Server의 해당 릴리스에도 반영될 예정이라고 설명합니다.